次元削減手法における PCA と t-SNE について考える
機械学習において、特徴量の数が多すぎると、以下のような問題が発生する可能性がある:
- 過学習(overfitting)
- 処理速度の低下
- 3つ以上の特徴量があると可視化しにくい
そのため、特徴量の次元削減を行う必要が出てくる。実務において、数百・数千もある特徴量の中から手作業で特徴を選定するのは明らかに賢明な方法ではない。そこで以下では、機械学習でよく使われる2つの次元削減手法を紹介する。
PCA(Principal Component Analysis)主成分分析
PCA を紹介する前に、まずは僕たちの目標を定義しておこう:
n 個の特徴空間を持つサンプルを、k 個の特徴空間を持つサンプルへと変換する。ただし k < n とする
以下が PCA の主な手順だ:
- データを標準化する
- **分散共分散行列(covariance matrix)**を作成する
- **特異値分解(SVD)を用いて固有ベクトル(eigenvector)と固有値(eigenvalue)**を求める
- 通常、固有値は大きい順に並べられ、そこから k 個の固有値と固有ベクトルを選択する
- 元のデータを固有ベクトル上に射影(マッピング)し、新しい特徴量を得る
PCA で最も重要な部分は特異値分解であるため、次のセクションでは特異値分解について話していこう。
特異値分解の直観的理解
行列分解の中で、特異値分解は非常に有名な手法だ。行列分解の高校数学における最も一般的な用途は方程式を解くこと(LU 分解など)だが、特異値分解の公式から直観的に理解することができる:
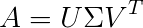
ここで A は m × n の行列、U と V はともに直交行列、𝛴 は特異値行列である。特異値行列は行列 A に対応する固有値であり、PCA においては主成分とも呼ばれ、情報を保持する重要度を表す。通常は大きい順に対角成分に並べられ、対称行列となる。
では、ここでの A は何に対応するのだろうか?もちろん僕たちの特徴量なのだが、注意すべき点として、ここでの A は通常**分散共分散行列(covariance matrix)**を用いて計算する。データは必ず正規化してから特異値分解を行うことを覚えておこう。
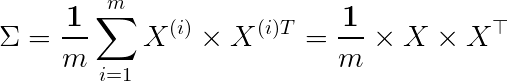
分散共分散行列(covariance matrix)
分散共分散行列はよく Sigma で表されるが、上記の 𝛴 と混同しないようにしよう。したがって、次元を削減したい場合は、U の最初の k 列に対応する 𝛴 の固有ベクトルを掛けることで、新しい特徴量を導き出すことができる。幾何学的な観点から見ると、以下のようになる。
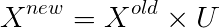
このような幾何学的演算は、実際には X を U の最初の k 個のベクトルに射影することに他ならない。
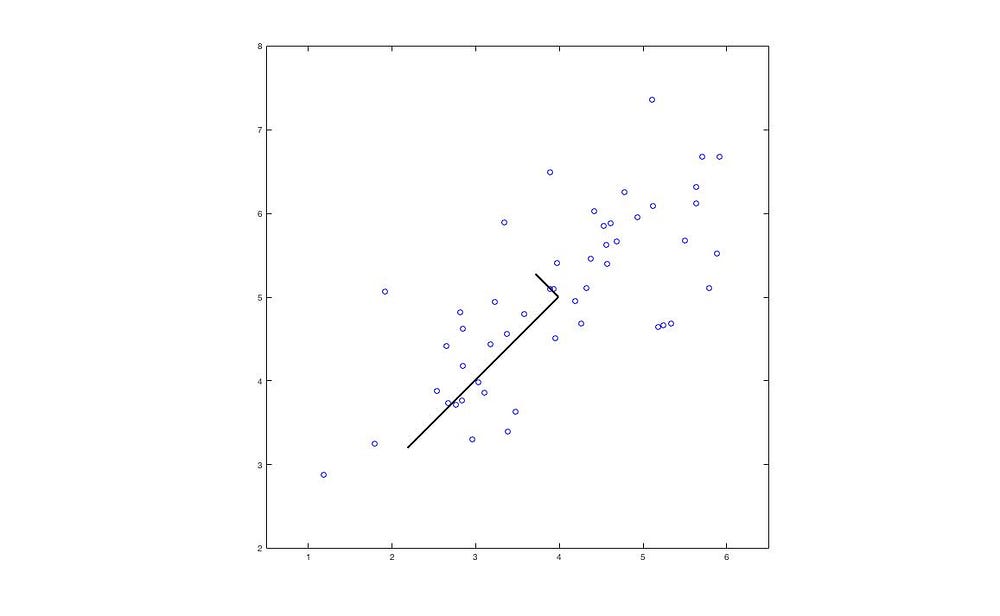
中の黒線が固有ベクトルで、長さが固有値である。
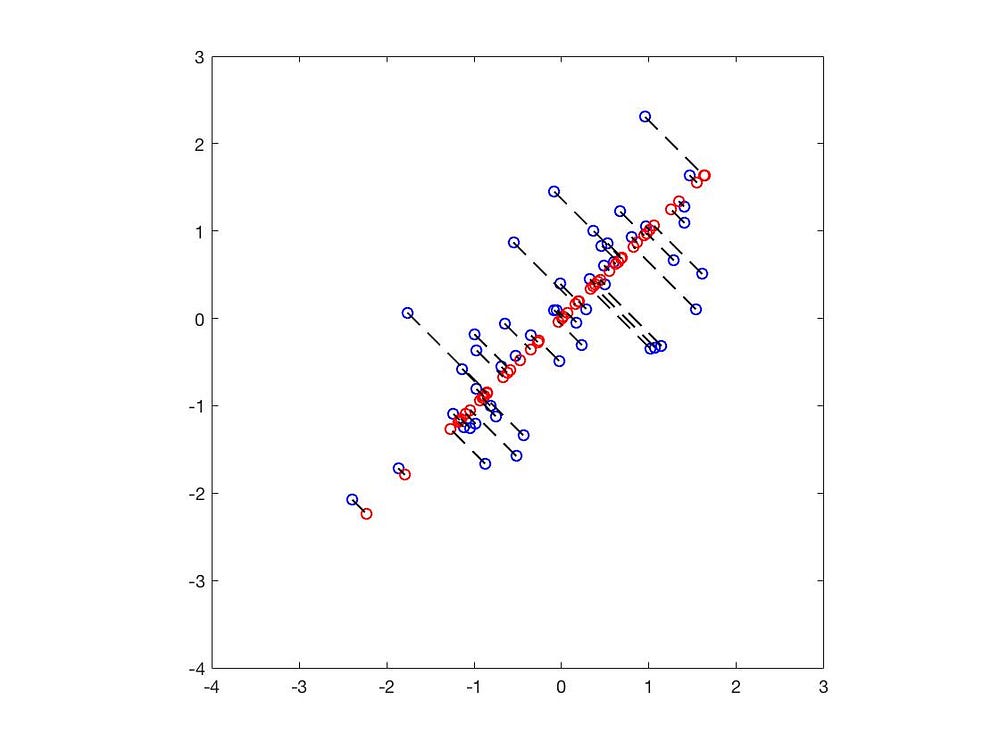
中の青い点はデータの元の位置であり、赤い点は固有ベクトル上に射影された位置だ。以上により、2次元のデータを1次元に落とすことに成功した。
もちろん、3次元から2次元に削減することも可能だ:
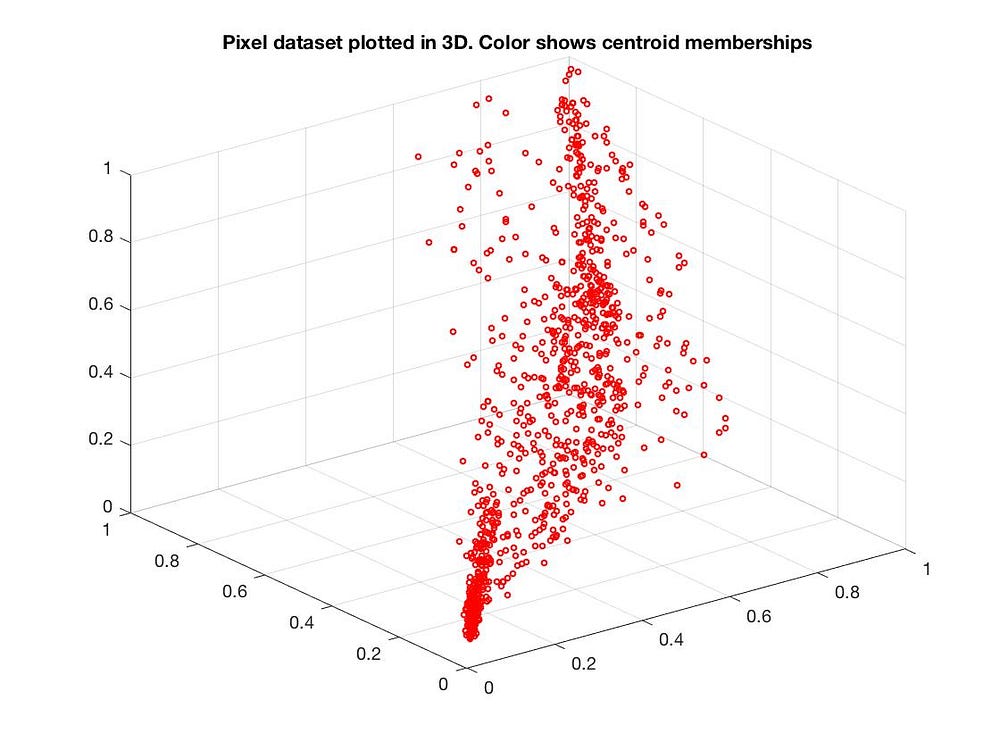
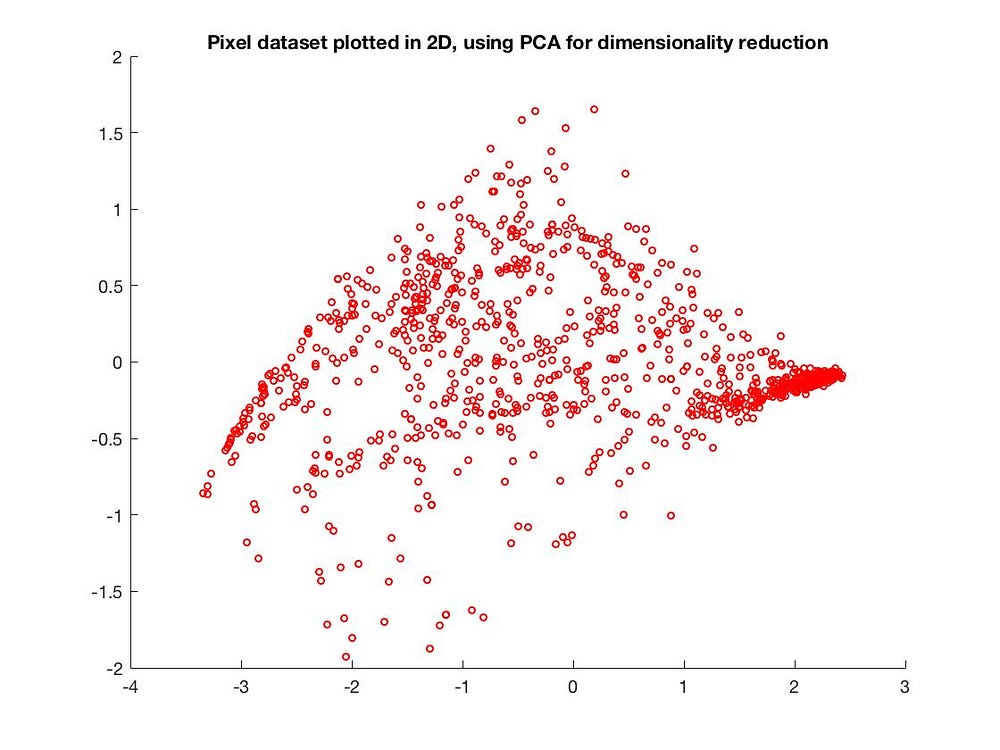
PCA の応用
次元を削減する際、僕たちは最も重要な特徴量を残し、残りのあまり重要ではない特徴量を直接切り捨てたいと考える。
例えば人を識別する際、最も重要な判別基準はおそらく目、鼻、口などであり、肌の色や髪の毛などの特徴量は切り捨てることができる。実際、顔認識においても PCA を使った次元削減がよく行われている。
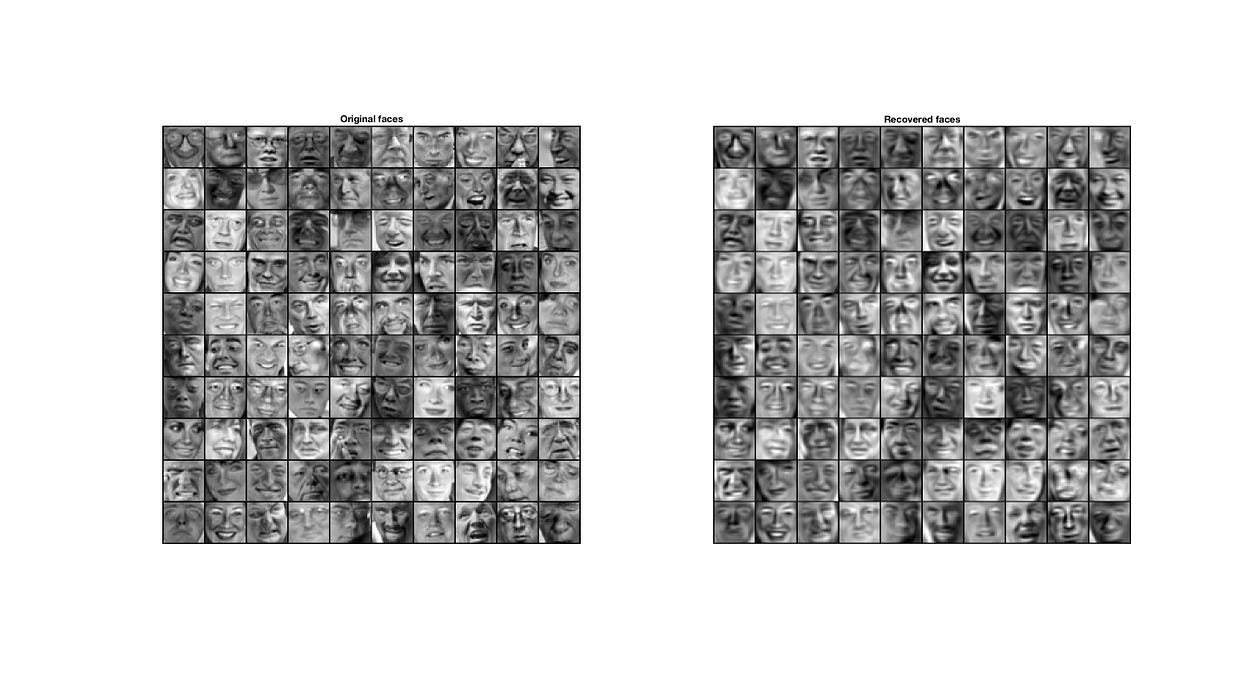
これは特異値分解のかなり直観的な理解であり、紙幅の都合上深く踏み込むことはできない。特異値分解に興味があれば、各自Wikipediaを参照してほしい。
t-SNE
PCA は非常に直観的で効果的な次元削減手法だが、3次元から2次元に変換した際に見られるように、一部のデータのクラスタが完全にひと固まりに混ざり合ってしまうことがある。
PCA は線形な次元削減手法であるため、特徴量同士の関係が非線形である場合、PCA を使うと**過小適合(underfitting)**を引き起こす可能性がある。
t-SNE も次元削減手法の1つだが、高次元と低次元の関係を表すためにより複雑な数式を用いている。t-SNE は主に、高次元データをガウス分布の確率密度関数で近似し、低次元データ部分は t 分布を用いて近似する。そして KL ダイバージェンスを用いて類似度を計算し、最後に勾配降下法(または確率的勾配降下法)で最適解を求める。
ガウス分布の確率密度関数
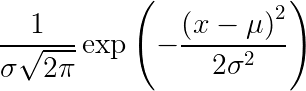
ここで X は確率変数、𝝈 は分散、𝜇 は平均である。
したがって、元の高次元データはこのように表すことができる:
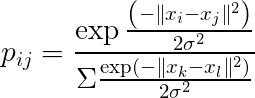
一方、低次元データは t 分布の確率密度関数を用いてこのように表すことができる(自由度は 1):
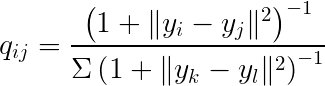
ここで x は高次元空間のデータ、y は低次元空間のデータである。P、Q はそれぞれ確率分布を表す。
なぜ低次元データの近似に t 分布を使用するのか?主な理由は、低次元に変換した後は必然的に多くの情報が失われるため、外れ値の影響を受けないようにするために t 分布を利用できるからだ。
t 分布はサンプルサイズが小さい場合、母集団の分布状況をより適切にシミュレートでき、外れ値の影響を受けにくい。
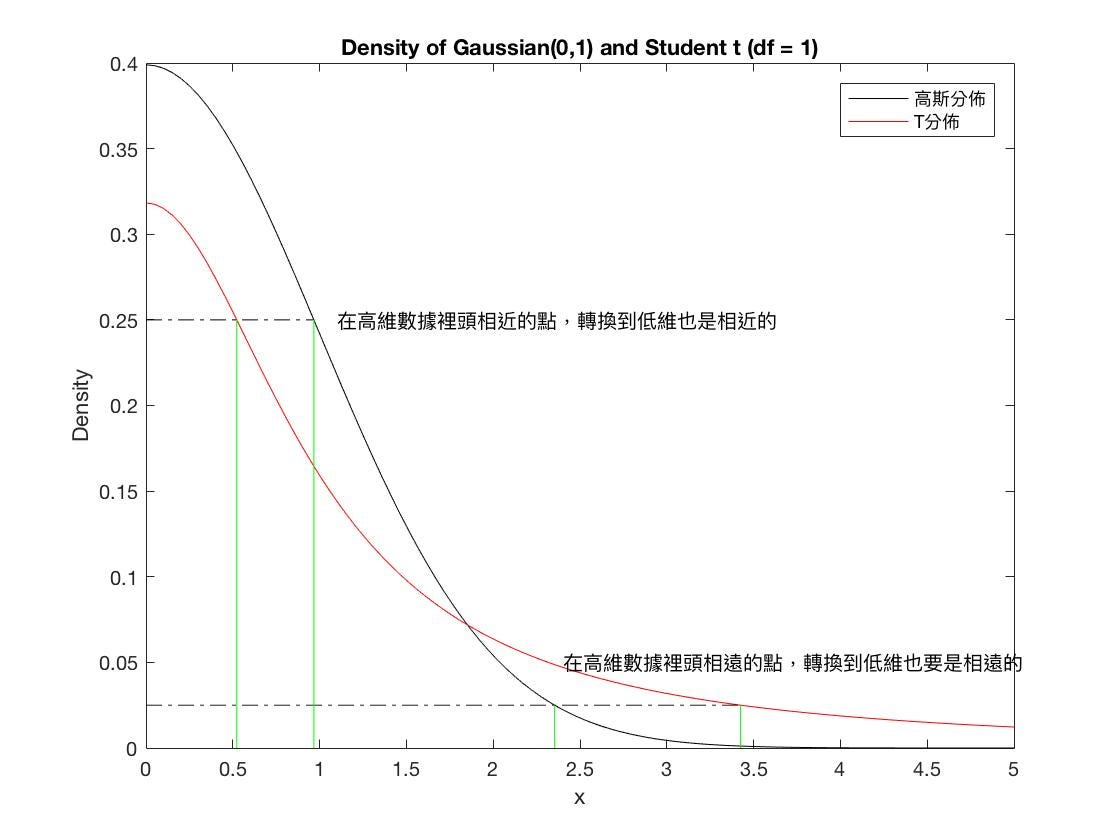 t 分布とガウス分布の確率密度関数
2つの分布間の類似度
2つの分布間の類似度を求めるには、よく KL ダイバージェンス(Kullback-Leibler Divergence)が用いられ、相対エントロピー(Relative Entropy)とも呼ばれる。
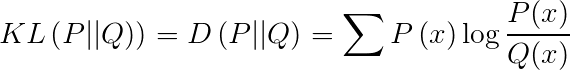
t-SNE では、ハイパーパラメータとしてパープレキシティ(Perplexity)が使用される。
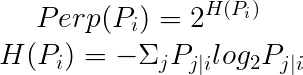
論文では、通常パープレキシティは 5 〜 50 の間に設定することが提案されている。
コスト関数(Cost function)
KL ダイバージェンスを用いてコストを計算する:
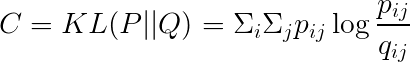
勾配を求めると、次のように書ける:
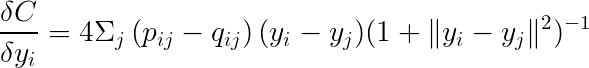
最後に勾配降下法(または確率的勾配降下法)を用いることで、最小値を見つけることができる。
実測:MNIST を使ったテスト
テストデータセットはここからダウンロードできる。まずは PCA を使って2次元に削減してみよう。
PCA
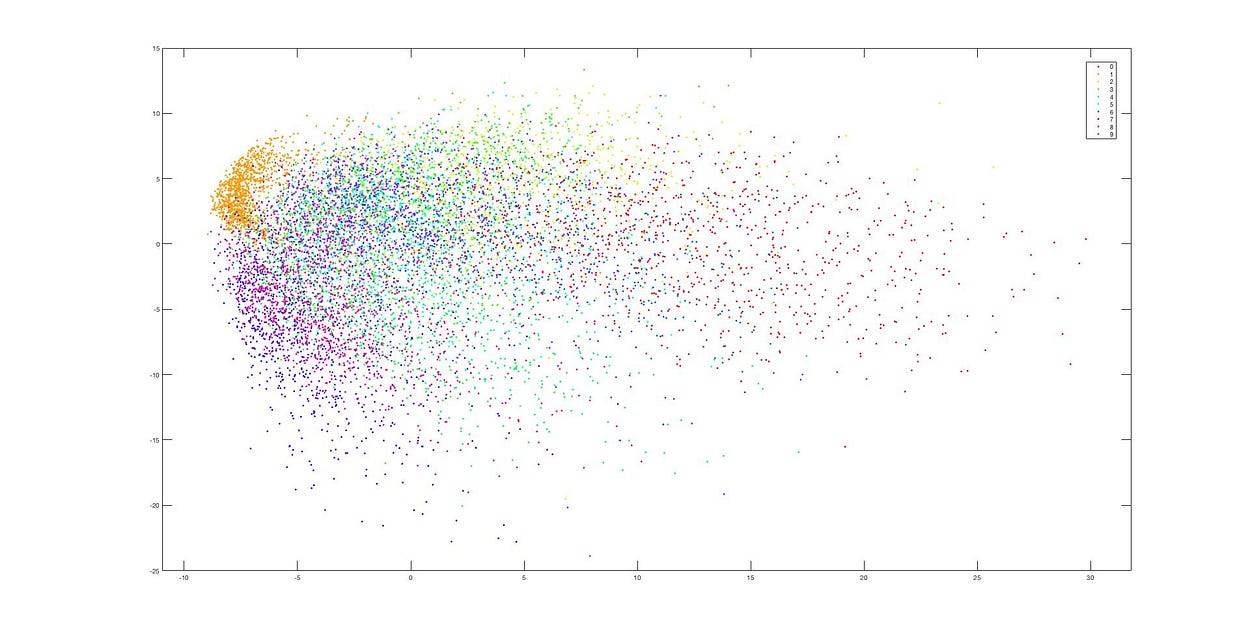 PCA による次元削減
2次元に削減した後、データがほぼひと固まりになってしまい、クラスタがまったく見分けられないことがわかる。これは、PCA の線形次元削減の過程で情報が多く失われすぎたためだ。
t-SNE
続いて t-SNE を使ってテストする。
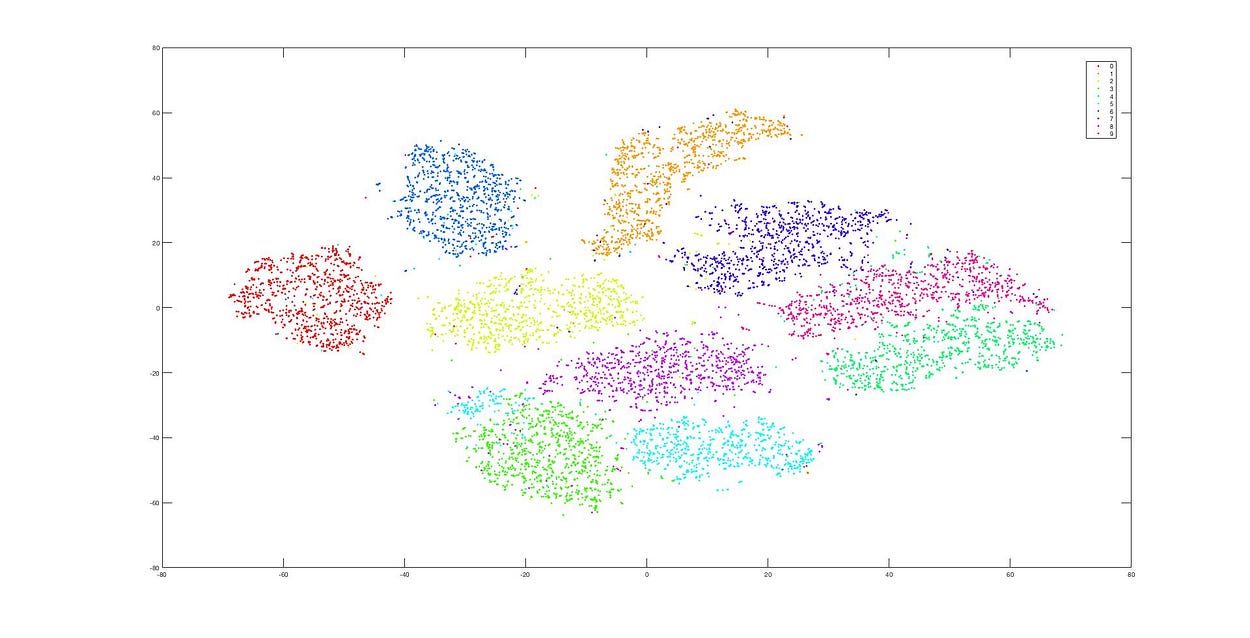 t-SNE による次元削減
これが t-SNE を使用した後の次元削減結果だ。次元削減後も、データが非常に明確にクラスタリングされていることがわかる。これら2つの図から、両者(PCA、t-SNE)の違いが極めてはっきりと見て取れる。
まとめ
その後、t-SNE のパフォーマンスを改善する一連のアルゴリズムが提案された。詳細については Accelerating t-sne using tree-based algorithms を参照してほしい。sklearn、R、MATLAB など、人気のあるデータ分析プログラミング言語の多くにも実装されている。
しかしながら、t-SNE は線形次元削減ではないため、実行時間は PCA よりもかなり長くなる。
- 特徴量の数が多すぎる場合、PCA を使用すると次元削減後の特徴量が過小適合(underfitting)を起こす可能性がある。そのようなときは t-SNE による次元削減を検討するとよい
- t-SNE の実行には比較的多くの時間が必要となる
- 論文中には他にもいくつかの最適化テクニック(パープレキシティの選び方など)があるが、まだ読み切れていないため、今後徐々に追記していく予定だ
参考資料
- Van der Maaten L, Hinton G. Visualizing data using t-SNE
- Accelerating t-sne using tree-based algorithms 様々な木構造アルゴリズムを利用して t-SNE の計算を高速化
- 線代啟示錄 - 奇異值分解
本記事は medium にも同時掲載されている
関連記事
- 測定が目標になるとき:窓税からPull Request数まで かつて僕は小さなツールを自作し、四半期で自分がどれだけPRに貢献したか、レビューコメントをどれだけ残したか、チケットをどれだけ消化したかを集計して、上司にアウトプットを証明しようとしたことがある。上司は淡々と、評価はアウトプットだけで見るものではないと言った。数年後、僕はようやく理解した――測定が目標になるとき、それはもはや良い測定ではなくなるのだ。英国の窓税、ハノイのネズミ駆除の報奨金から、現代のPR数による開発者評価に至るまで、そのメカニズムはまったく同じだ。
- Cloudflare Images を画像ストレージ・変換ソリューションとして使う ウェブページに画像を1枚置くのはフロントエンドにとって最も簡単なことだが、リサイズや各種フォーマットの生成、さらにはトラフィックの負荷に耐えることまで完璧にやろうとすると、実際には一つの包括的なソリューションが必要になる。僕はその後、すべて Cloudflare Images に任せるようになり、オリジナル画像1枚だけを渡すようにしている。
- もう AWS Access Key を使うのはやめよう Access Key は AWS において見落とされがちなセキュリティリスクだ。OIDC と IAM Role を組み合わせることで、GitHub Actions にシークレットを一切保持させることなく、安全に AWS リソースを操作できるようにする。
- データベース主キー:AUTO_INCREMENT、UUID、そしてUUIDv7 バックエンド開発で度々直面する主キーの決定。auto incrementを使うべきか、それともUUIDか?衝突への懸念は?UUIDv7とcreated_at + インデックスの性能差はどれほどか?実際に2,000万件のデータで検証したベンチマークと設計上の意思決定を解説する。