Ramda のいくつかの API について
はじめに
Ramda は非常に便利なライブラリだ。lodash や underscore を知っていれば、Ramda を 関数型プログラミング(functional programming) 版の lodash だと捉えることができる。それらの API には多くの類似点があるが、違いは Ramda 自体が FP の機能を持っている点だ。どんな API でも、引数をすべて渡さなければ Ramda が自動的にカリー化(curry)してくれるため、非常に高い柔軟性が得られる。
例えば lodash では、API の一般的な使い方は以下のようになる:
_.map([1, 2, 3], n => n * 2) // [2, 4, 6]一方で Ramda では次のようになる:
R.map(n => n * 2, [1, 2, 3]) // [2, 4, 6]あるいは、このように書くこともできる:
const times2 = R.map(n => n * 2) // return function
times2([1, 2, 3]) // [2, 4, 6]
この方法を使えばデータに縛られることがなくなり、再利用性を高めることができる。
FP についてもっと詳しく知りたいなら、僕はこの記事をおすすめする:なぜ関数型プログラミングが重要なのか
直感的な関数型プログラミング
- 同じ input に対しては必ず同じ output を返し、外部の状態によって結果が変わることはない
- 副作用がない
なぜ Ramda を選ぶのか
Ramda の API は非常に多く、その大半はとても直感的なので、一つひとつ詳しく説明する必要はないだろう。しかし、Ramda には開発の複雑さを軽減するのに役立つ優れた API がたくさんある。以下では、僕が見ておく価値があると思う API をいくつか紹介する。
propEq
プロパティ名として文字列を受け取り、渡されたオブジェクトのプロパティ値が等しいかどうかを比較する。
const obj = {
  name: "kalan",
}

propEq("name", "kalan")(obj) // true

// 等價於
const propEq = (name, value) => obj => {
  return obj[name] === value
}
zipObj
渡された引数を object に圧縮(結合)する。
R.zipObj(["id", "title"], ["2", "mytitle"])
/*
{
  id: '2',
  title: 'mytitle'
}
*/
ifElse
分岐のロジックを扱う際に非常に便利だ。「なぜ普通の if…else をそのまま使わないのか?」と思うかもしれないが、Ramda の API はすべて関数を返すため、compose を使って他の API と組み合わせることができる。
compose
複数の関数を合成し、内側から外側へと実行していく。中学や高校でよく見かける関数の問題 f(g(h(x))) を思い浮かべるといい。つまり、まず h(x) の値を計算し、順番に適用していくわけだ。
const a = compose(
  toInteger,
  toCurrency("TWD"),
  toUppercase
)("125000")
useWith
1つの関数と、関数の配列を受け取る。データを関数の配列に渡して計算された結果を、最初の関数に渡す。
useWith をうまく使えば、ポイントフリー(point-free)スタイルを実現するのに役立つ。
const currencies = [
  { name: "TWD", shape: "$" },
  { name: "USD", shape: "$" },
  { name: "JPY", shape: "¥" },
  { name: "CAD", shape: "$" },
]

// without useWith
const getCurrency = (name, dic) => R.find(R.propEq("name", name), dic)

getCurrency("TWD", currencies) // $

// with useWith
const getCurrency = R.useWith(R.find, [R.propEq("name"), R.identity]) // 將第一個參數傳入 R.propEq,第二個參數傳入 R.identity,運算後的結果分別丟給 R.find 的第一與第二個參數。

getCurrency("TWD", currencies)
useWith を使ったことで、name と dic という2つの引数を排除できた。
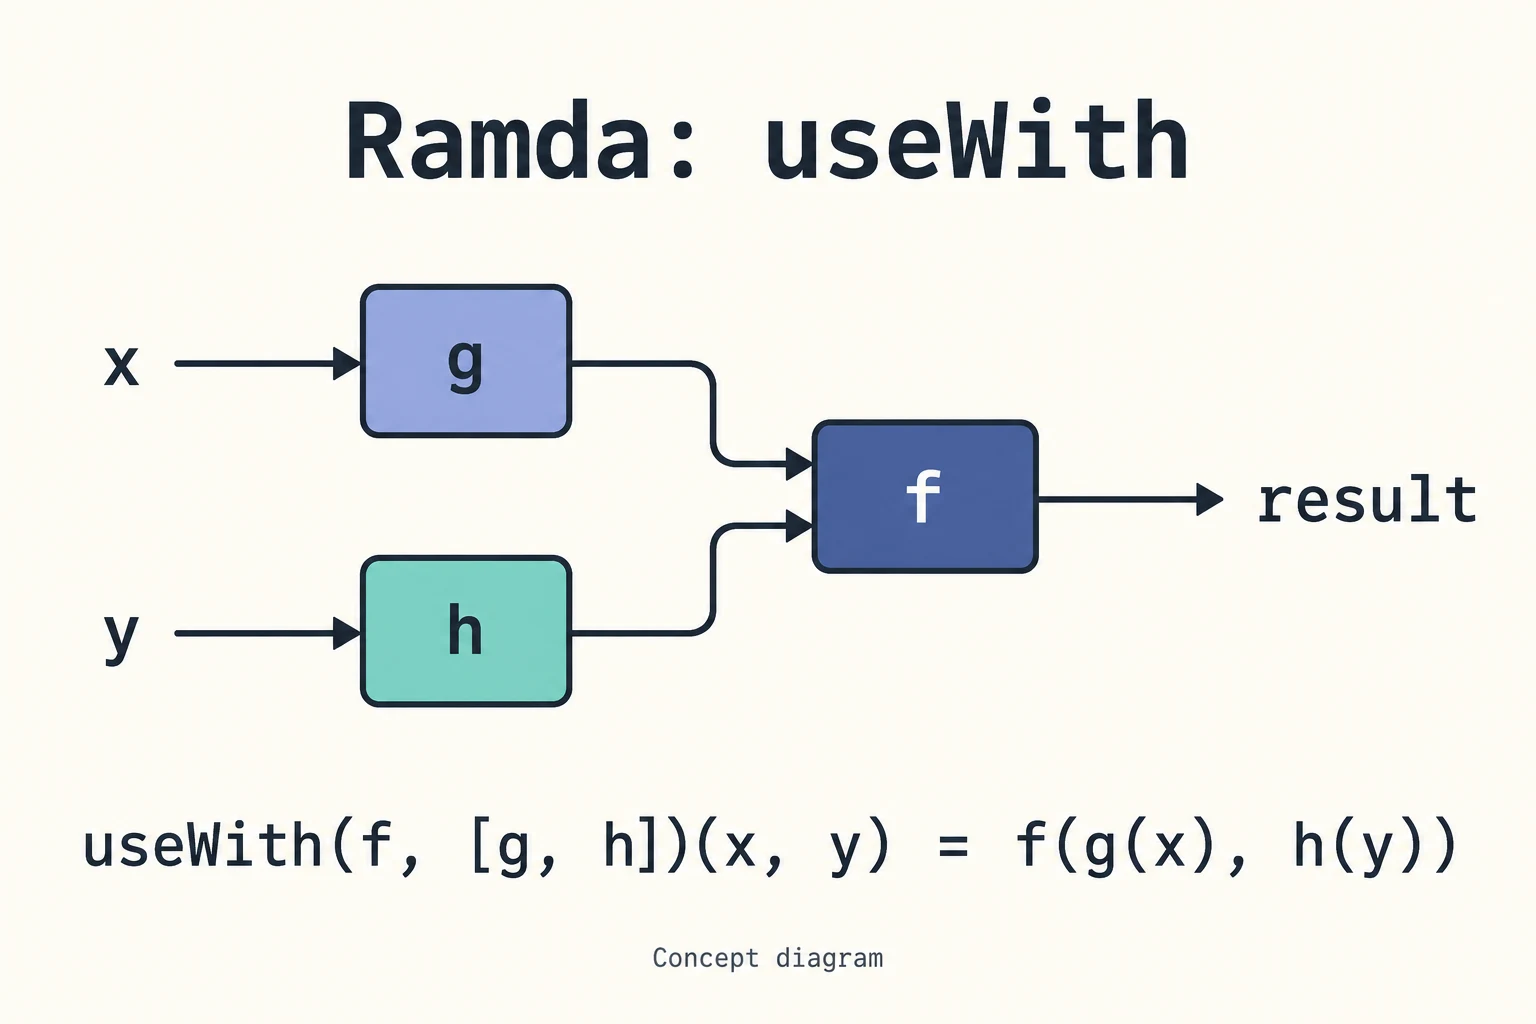
converge
この関数は先ほどの useWith と少し似ているが、converge は1つの引数のみを受け取る。以下の図を見れば、この2つの違いが直感的にわかるだろう。
const numbers = [1, 2, 5, 8, 10]

const getRange = R.converge(substract, [getFirst, getLast])(numbers) // return 9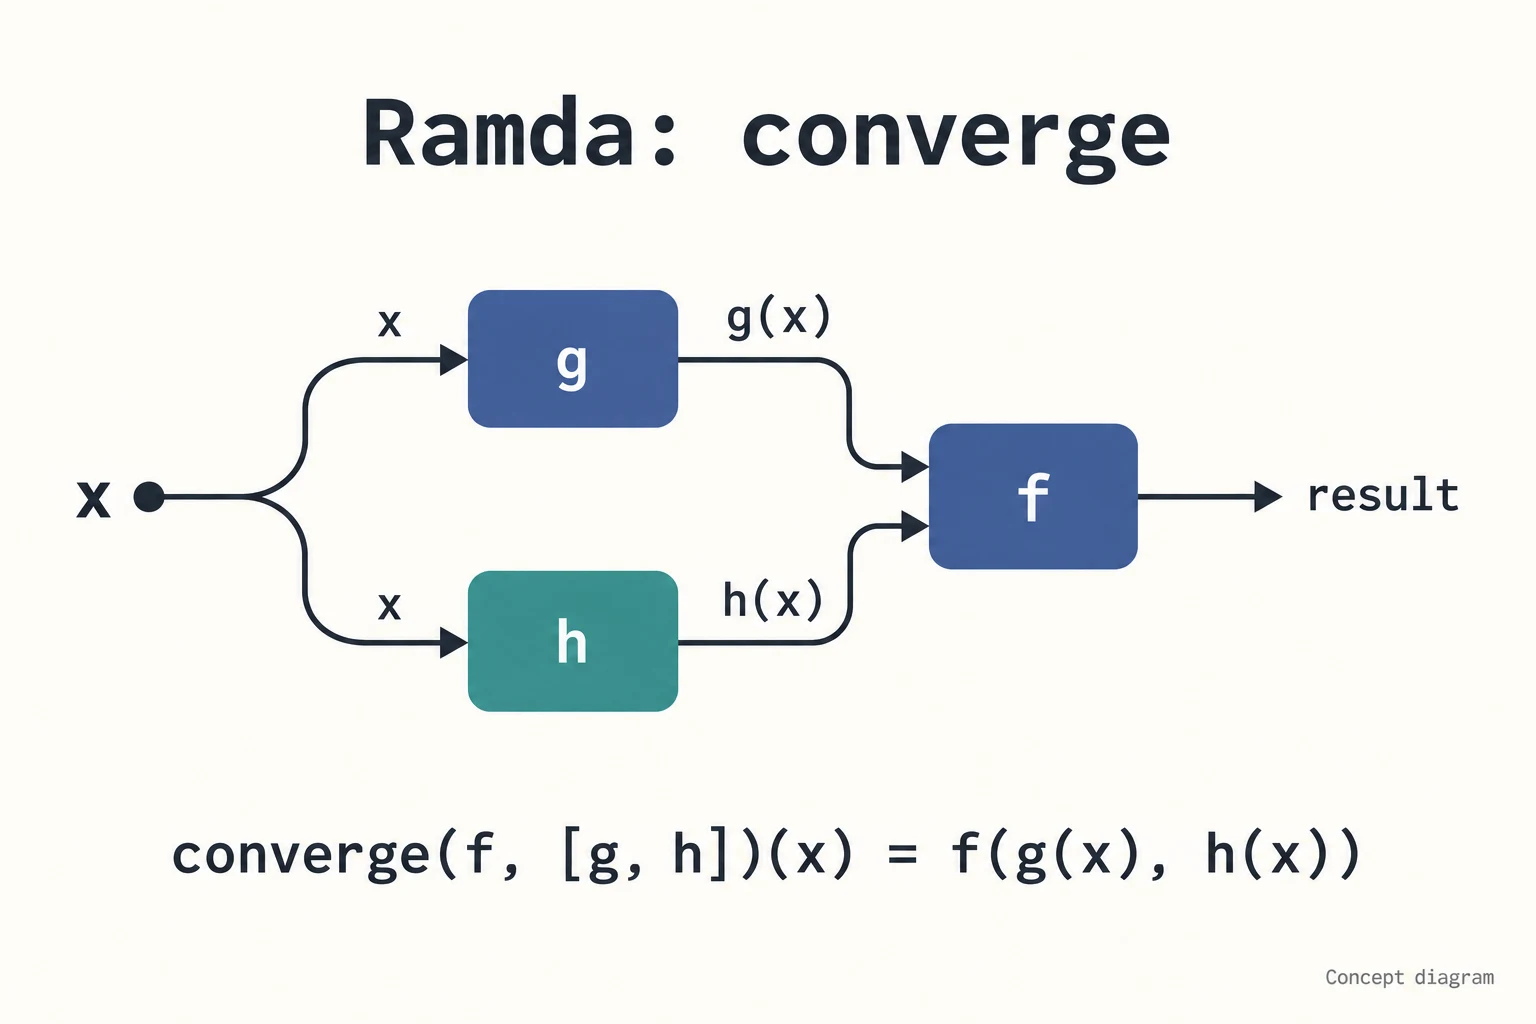
identity
直感的すぎて……逆にどう説明したらいいかわからない。直接コードで説明したほうが早い。
const identify = arg => argでは、なぜこのようなことをするのだろうか?時には関数を組み立ててチェーン可能(chainable)にする必要がある場合があり、そんな時にこの identity 関数が役に立つ。
tap
指定した関数に引数を渡し、その後その値をそのまま返す。これはデバッグや他のサードパーティツールと連携する際に非常に便利だ。
tap(console.log)("hello world") // 傳入 hello world 給 console.log,並且回傳 hello world 這個值上記の例だけでは tap の有用性がわかりにくいかもしれないので、compose と組み合わせて使ってみよう。
const uploadToMedium = article => API.postArticle(article)
const notifyAdmin = article => API.notify(article, subscribers)
const log = article => Logger.log(article)
const preprocessArticle = article => article.toLowerCase()

const publishPostFlow = article =>
  compose(
    preprocessArticle,
    R.tap(uploadToMedium),
    R.tap(notifyAdmin),
    R.tap(log)
  )

publishPostFlow(article)
こうすることで、わざわざ return article のようなコードを書くことなく他のサービスと簡単に連携できるようになり、ボイラープレートコードの手間を減らせるだけでなく、バグを生む可能性も減らせる。
pluck
文字どおりの意味で、指定されたキーの値を抽出して新しい配列にする。ネストされたオブジェクトから値を取り出すときにとても役立つ。例えば:
const data = [
  {
    id: "1",
    content: "content...",
  },
  {
    id: "2",
    content: "content...",
  },
  {
    id: "3",
    content: "content...",
  },
]

const getIds = R.pluck("id", data) // return ['1','2','3']
pick, pickBy, pickAll
実務ではオブジェクト内のすべてのプロパティを使うわけではなく、一部のプロパティだけを取り出して使いたいことが多い。この3つの pick 系の関数を使えば、それを簡単に行うことができる:
const data = {
  url: "https://api.github.com/repos/example/magazine/issues/1",
  repository_url: "https://api.github.com/repos/example/magazine",
  labels_url:
    "https://api.github.com/repos/example/magazine/issues/1/labels{/name}",
  comments_url:
    "https://api.github.com/repos/example/magazine/issues/1/comments",
  events_url: "https://api.github.com/repos/example/magazine/issues/1/events",
  html_url: "https://github.com/example/magazine/issues/1",
  id: 252372781,
  number: 1,
  title: "test issue",
}

R.pick(["url", "repository_url", "id", "name"], data) // 回傳這三個屬性的值,如果找不到此屬性直接忽略

R.pickAll(["url", "repository_url", "name"], data) // 回傳值如果屬性存在,沒有的話會回傳 undefined

const isURL = (value, key) => key.indexOf("_url") !== -1
R.pickBy(isURL, data) // 回傳任何屬性含有 _url
pathOr
フロントエンドでバックエンドの API を呼び出す際、返ってくる JSON がかなり深い構造を持っていることがある。通常のように a && a.b && a.b.c という形で値を取得しようとすると、コードがかなり煩雑になるだけでなく、階層が深くなるほど多くの条件分岐を書かなければならなくなる。
pathOr は値を取り出すパスの順序として配列を受け取り、値の取得結果が undefined だった場合にはデフォルト値を返す。
const article = {
  id: "116208916",
  author: {
    information: {
      birthday: "1994-11-11",
      name: "kalan",
    },
    subscribers_count: 1239,
  },
  content: {
    title: "title",
    body: "body",
  },
}
バックエンドから返ってくるフィールドが不足しているとエラーが発生する可能性が高いが、そのような場合に pathOr を使って処理できる。こうすれば、誕生日に値がない場合でも「未提供生日」という文字列で代替できる。
const getBirthday = R.pathOr(
  ["author", "information", "birthday"],
  "未提供生日"
)
getBirthday(article)
memoize
素数や階乗の計算など計算量が比較的多い場面で、値を取得するたびに再計算しないように、memoize 関数を使ってすでに計算した結果をキャッシュできる。
まとめ
Ramda は非常に便利なライブラリだ。この記事では通常あまり見かけないいくつかの API を紹介したが、Ramda 自体の API は非常に豊富だ。compose と組み合わせることで独自の関数を自由に組み立て、上記の方法を活用して関数をシンプルに保つことができる。
もし君もこのようなコードスタイルが好きなら、関数型プログラミングの世界へようこそ。
関連記事
- Three.js で僕の部屋を表現する 僕が React Three Fiber を使って実際の自分の部屋をブラウザ上に再現し、実世界のオブジェクトを目録に見立て、空間の記憶を通してここ数年の生活と仕事について語った話。
- フロントエンドで画像を扱う際に注意すべきこと Jake Archibaldの記事を起点に、現代のレスポンシブ画像の書き方を整理する。なぜwidth/heightを付ける必要があるのか、CSSのaspect-ratioはいつ使うべきか、AVIFとWebPの選び方、そしてpicture/source/srcsetを使ったモバイル向け画像の切り替えについて。
- CSS field-sizing — たった1行のCSSでフォーム要素を自動リサイズする かつてtextareaの自動高さ調整は、JavaScriptでscrollHeightを監視するしかなかった。しかしCSSのfield-sizing: contentなら、わずか1行で代替でき、textarea、input、selectに対応している。本記事では従来のやり方のペインポイントと、field-sizingの使い方をまとめる。
- リンクの下線をもっと見栄え良くする:text-underline-offset デフォルトでは下線と文字が近すぎて、このスタイルを好まないデザイナーもいるし、僕自身もあまり綺麗ではないと感じていた。