数値にカンマを付与する正規表現
通貨などを表示する際、元の数値を人間が読みやすい形式に変換したいという要件がよくある。例えば:
- 1234567 → 1,234,567
- 10000 → 10,000
フロントエンドでは、いくつかの方法でこれを実現できる:
Intl.NumberFormatを使う(古いブラウザでは対応していない可能性があり、polyfill が必要)- 正規表現と
.replaceを使う
この問題については StackOverflow でもかなり多くの議論がなされており、その中で最も人気があるのはおそらくこの記事だろう:How to print a number with commas as thousands separators in JavaScript
解答には多くの種類があるが、大まかなパターンとしては概ねこの2つに集約される:
const reg1 = /\B(?=(\d{3})+$)/
const reg2 = /(\d)(?=(\d{3})+$)/
この記事では、これら2つの正規表現の違いと実際の動作の仕組みについて解説する。最後に実際のパフォーマンスも測定してみる。
はじめに
本題に入る前に、事前に理解しておくべき重要な概念がいくつかある。それは positive lookahead(先読み)、negative lookahead(否定先読み)、そして word boundary(単語境界)だ。これらは正規表現を学ぶ際に見落とされがちだが、実際には非常に強力な概念である。
Positive lookahead と Negative Lookahead
正規表現において、positive lookahead は ?= という記号で表される。例えば a(?=b) という表現で説明すると、この正規表現の意味は「直後に文字 b が続く a」にマッチする、ということになる。ここで特に注意すべきなのは、?= 自体はマッチ結果に含まれないため、この正規表現が実際にマッチするのは a だけという点だ。
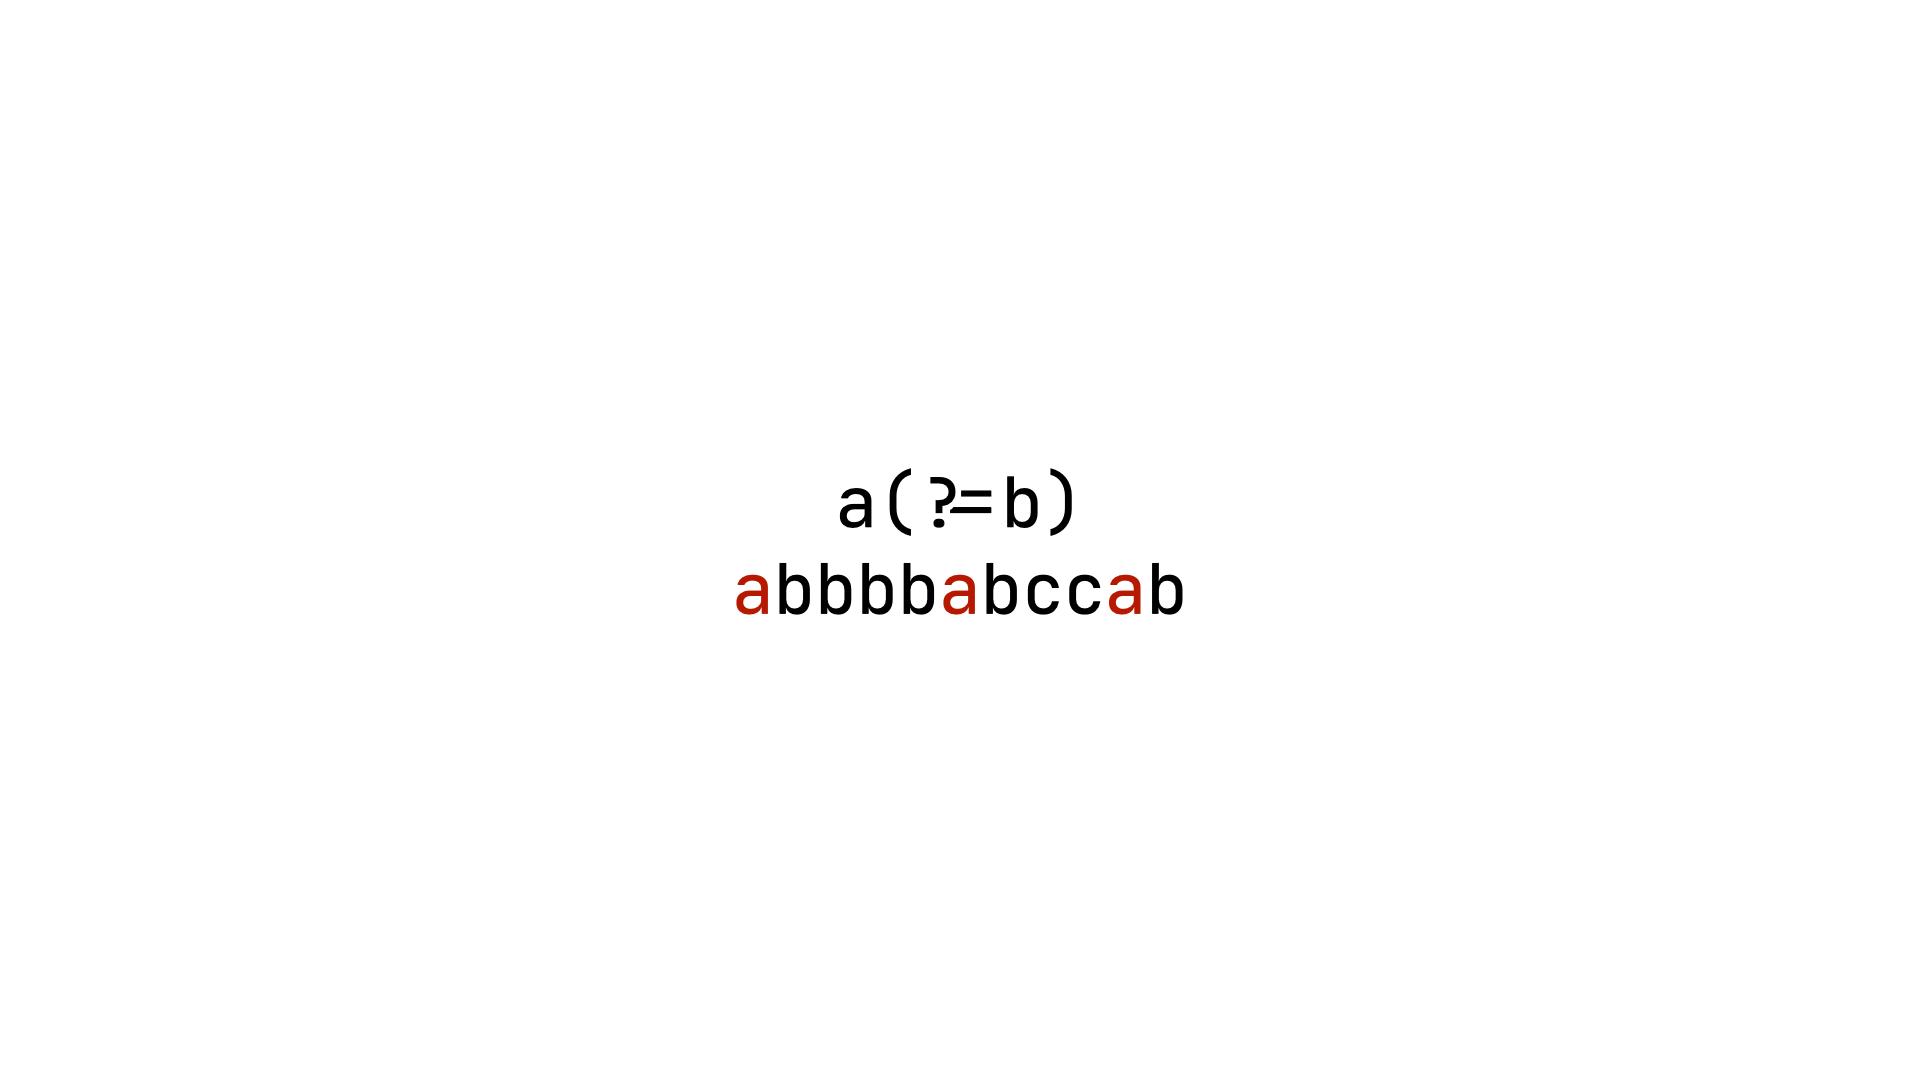
上の図のように、上述の正規表現では a だけがマッチする。
文字だけでなく、lookahead の構文は任意の有効な正規表現を受け入れることができる。例えば ,(?=(?:\d{3})+$) の場合、この正規表現の意味は「直後に3桁の数字の連続が1回以上繰り返され、ちょうど末尾で終わる ,」にマッチする、ということになる。

negative lookahead は ?! という記号で表され、positive の逆になる。例えば a(?!b) であれば、「直後に文字 b が続かない a」にマッチすることを表す。
特に注意が必要なのは、positive lookahead も negative lookahead も zero-length(幅ゼロ)の表現である点だ。つまり、それ自体はいかなる文字もマッチしないため、長さは 0 になり、アンカーのような役割を果たす。仮に文字を前置せずに (?=a) とだけ書いた場合、実行結果は次のようになる:

マッチには成功しているものの、マッチした長さは 0 であり、文字と文字の間に位置していることがわかるだろう。
冒頭に挙げた正規表現のうち、
/\B(?=(\d{3})+$)/ と /(?=(\d{3})+$)/ は意味がほぼ同じである(細かな違いはあるが)。なぜこの2つの表現がほぼ同じなのか?それについては以下で \b と \B を紹介しながら説明しよう。
\b と \B の意味
\b
正規表現における大文字と小文字は、通常は肯定と否定(正反対)の意味を持つことが多い。例えば \d が数字にマッチするのに対し、\D は数字以外にマッチする。そのため、まずは \b が何を意味するのかを理解しよう。MDN のドキュメントを参考にすると次のようになっている:
A word boundary matches the position where a word character is not followed or preceded by another word-character. Note that a matched word boundary is not included in the match. In other words, the length of a matched word boundary is zero.
また、word character(単語文字)がどのように定義されているかを理解するには、まず \w を理解する必要がある。\w は次のように定義されている:
包含數字字母與底線,等同於
[A-Za-z0-9_]。
\w が何であるかを把握したところで、文中の word character is not followed or preceded by another word-character(単語文字の前後に別の単語文字が続かない位置)が何を意味するのかを見てみよう。混乱を避けるため、ここでは \w を単語文字と呼ぶことにするが、\b は以下のような状況で現れる:
- 単語文字の先頭
- 単語文字と非単語文字の間
- 単語文字の末尾
図を見たほうが分かりやすいだろう:

実際、word boundary(単語境界)の概念そのままに「単語の端の部分」と理解してもよい。重ねて強調しておくが、他の文字を加えない場合、\b 自体は幅ゼロのマッチであるため、マッチする長さは常に 0 だが、マッチしていないわけではない。
文字と組み合わせた場合と混同しないようにしてほしい。例えば d\b は、「直後が単語境界である文字 d」にマッチすることを意味する。この場合、実際に文字 d がマッチされる:

\B
\B はその逆で、非単語境界(word boundary ではない位置)を表す。非単語境界とは何かというと、上の図で矢印がついていない位置のことだ。

正規表現を正しく解析する方法
正規表現を読み解けるようになるには、本来経験の積み重ねが必要だ。しかし、開発で使うものである以上、ある程度の概念は持っておいたほうがよい。正規表現は状態遷移機械(ステートマシン)の遷移として捉えることができる。例えば \d+ なら、このように表現できる:

一般的には初期状態(例えば数字以外が入力された場合は状態 0 に遷移してはならないなど)も加える必要があるかもしれないが、理解できれば十分だ。矢印の上にあり得る入力文字を置き、次の状態に遷移するかどうかを判断する。最終的な状態が終了状態(受理状態)であれば、そのマッチが受理されたことを意味する。

正規表現の解析を始めよう
方法 1:zero-length の特性を利用してマッチさせる
前提知識の解説を終えたところで、いよいよ分析に入ろう。まずは1つ目の表現を見てみる:/\B(?=(\d{3})+$)/g
先頭の \B は非単語境界の位置にマッチする。続いて (?=) の後ろの正規表現を見ると、(\d{3})+ は3桁の連続した数字が1回以上出現すること(333 や 666、123 など)を表す。続いて見る (?!) の後の正規表現では、\d は1つの数字にマッチすることを表す。これらを一連の意味として繋げると、**「(1つの数字の前が3桁の連続する数字ではなく、かつ1回から複数回マッチする)非単語境界にマッチする」**ということになる。
ここで面白いのは、後半の (\d{3})+$ の部分だ。この正規表現の意味は、マッチする結果の長さが必ず3の倍数であり、かつちょうど末尾で終わらなければならないということだ。例えば 123456 は長さが3の倍数だが、12345 は \d{3} に1つマッチするものの、末尾ではないためマッチしたとはみなされない。
この特性と \B の巧妙な活用により、例えば数値 1000000 であれば最終的に2箇所の位置にマッチすることになる。

したがって、.replace を呼び出すときは次のように書ける:
"1000000".replace(/\B(?=(\d{3})+$)/g, ",");上の図のマッチ結果に基づき、これら2箇所の位置に , が挿入されて 1,000,000 になる。この正規表現で $1, を使う必要がないのは、\B も (?=) も zero-length match であり、マッチした長さが 0 だからだ。
マッチングの過程は以下の動画で確認できる。ここでのマッチ回数はあくまで参考値であり、プログラミング言語によって挙動が異なる可能性もあるし、一部のステップを省略しているが、大まかな流れは以下のようになる:
方法 2:カンマを挿入すべき数字にマッチさせる
/(\d)(?=(\d{3})+$)/
これを見ると、\B が取り除かれて \d が追加されたこと以外、全体的には大きな違いがないことがわかる。ただし1点異なるのは、\d は実際に数字そのものにマッチする点だ。最終的な結果は次のようになる:
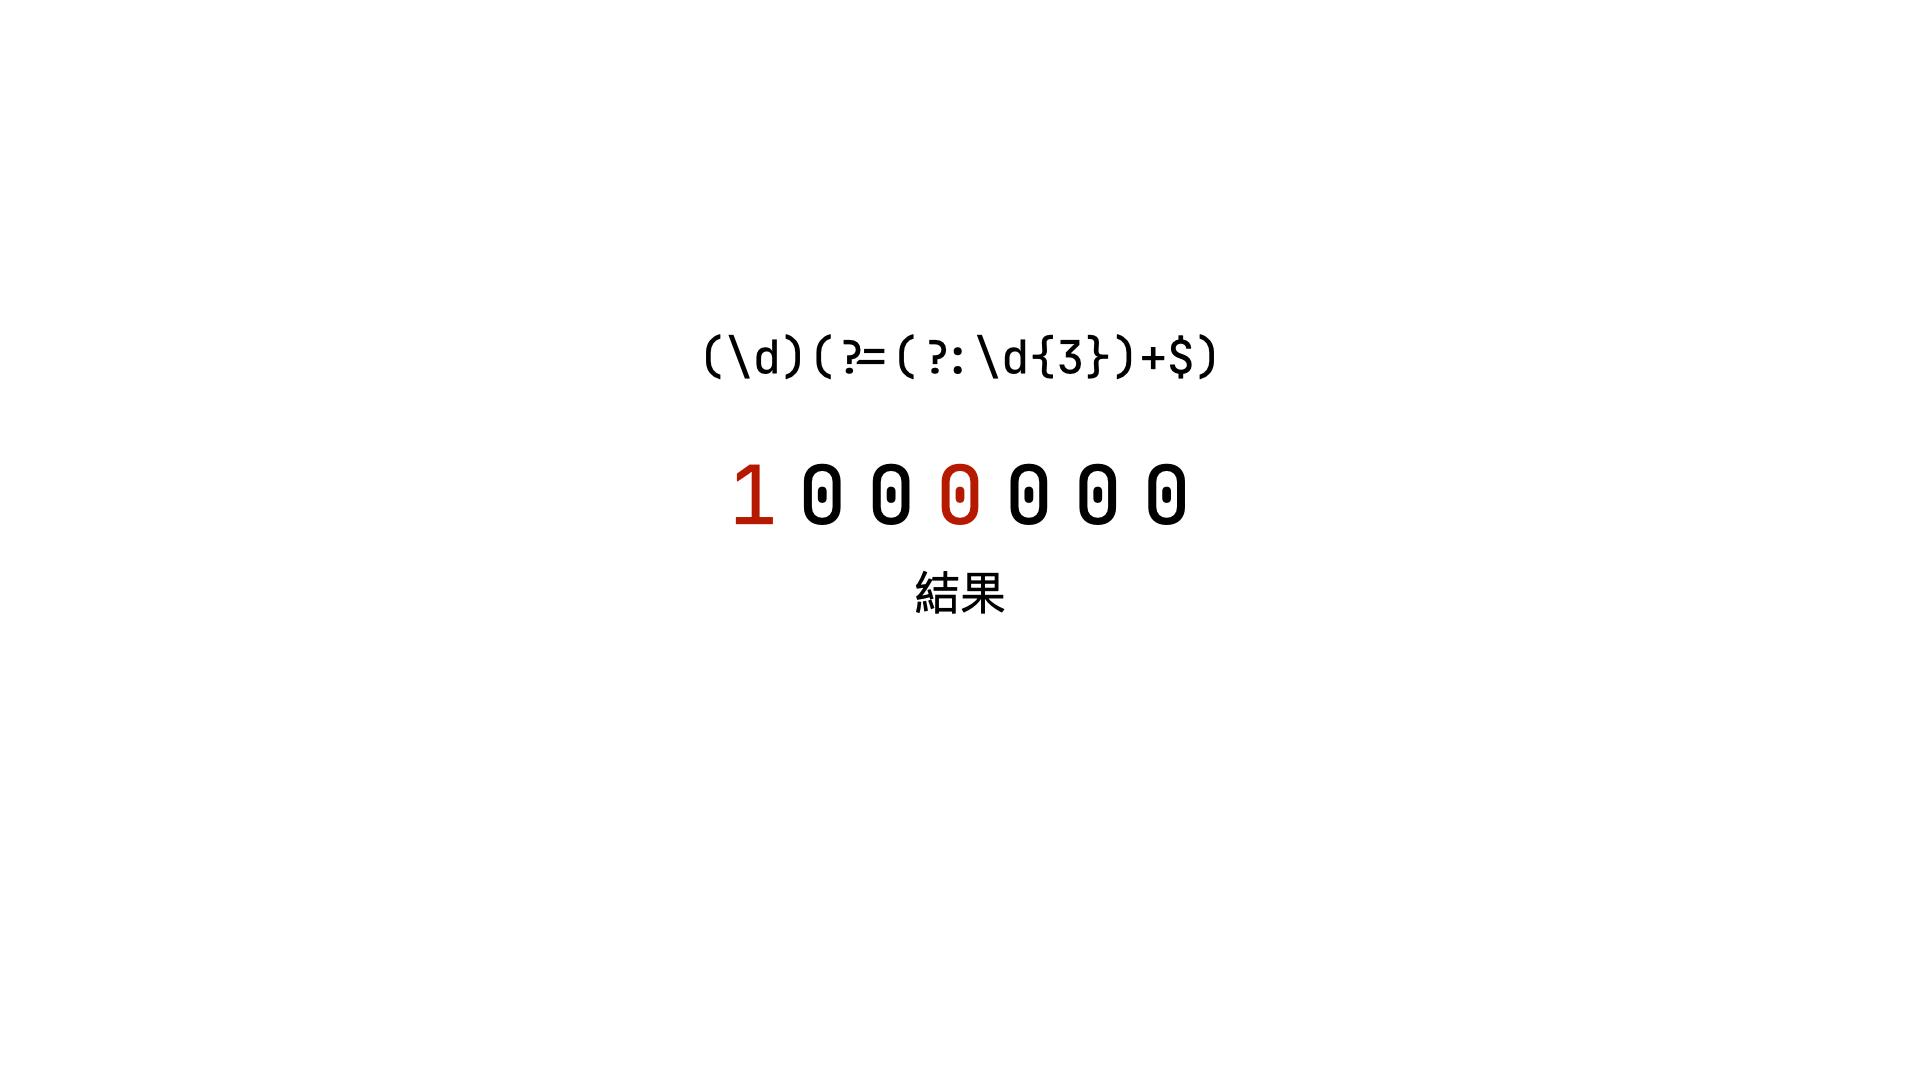
(画像内ではマッチ結果をグループに格納しないよう ?: を付けているが、結果は同じである)
僕自身の習慣として、グループ化した値を後で参照しない場合は ?: を使って非キャプチャグループにしておく。そうすることで他の人や未来の自分にとってもコードが読みやすくなるからだ。
全体の流れはおおよそ以下のようになる(途中でマッチに失敗する過程は省略している):
そのため、JavaScript では次のように書く:
"1000000".replace(/(\d)(?=(\d{3})+$)/g, "$1,"); // 注意這邊的 $1ここでの $1 は非常に重要だ。なぜならマッチした文字も一緒に保持して戻す必要があるからで、単に , に置き換えてしまうと ,00,000 のようになってしまう。
その他の考慮事項と方法
上記2つの正規表現ではいずれも (?=(\d{3})+$) をマッチ条件としているが、実務では小数点が含まれることもある。そうなると 1000.12 のような数値にはうまくマッチできなくなってしまう。
その場合、小数点がある場合に対応できるよう正規表現を修正する必要がある。例えば \b を加えて単語境界とすることで、小数点でマッチを止めるようにするなどの方法が考えられる。
また、ブラウザの API には Intl.NumberFormat がサポートされており、導入の手間なくすぐに使える。使い方は MDN のドキュメントを参照してほしい。
new Intl.NumberFormat('ja-JP', { style: 'currency', currency: 'JPY' }).format(number);パフォーマンスと考察
結果がどれも同じであるなら、考慮すべき点は「可読性」と「パフォーマンス」の2つに絞られる。
可読性や使いやすさの観点から言えば、最も優れているのは当然 Intl.NumberFormat だ。MDN の丁寧なドキュメントにわかりやすく書かれており、非常に使い勝手がよい。
唯一注意すべきなのはパフォーマンス面だ。ここで jsbench を使ってテストしてみた。すると、Intl.NumberFormat のパフォーマンスはほぼ半分近く遅いことがわかる。おそらく i18n のロードや各国の数値変換処理に多くのオーバーヘッドがかかっているのではないかと僕は推測している。

また、zero-length でマッチさせる方法は、\d でマッチさせる方法よりも約2倍速かった。これは zero-length の特性によるものだろうか?ただし注意が必要なのは、(\d{3})+ のような表現では、+ があるとバックトラッキング(backtracking)を行ってマッチングを試みるという点だ。つまり、可能な限り多くの結果にマッチしようとする。そのため、.+123 のような表現ではできるだけ多くの結果にマッチしようとし、マッチしなくなって初めて後ろへ遡る。大量のバックトラッキングは正規表現のパフォーマンス問題を引き起こすため、似たような表現を使う際には特に注意しなければならない。
実務においては、requestIdleCallback を利用して Intl.NumberFormat の初期化を遅延ロードし、パフォーマンスへの過度な影響を避けることもできるし、ロジックを関数でラップして他のファイルから実際に呼び出された時に初めて初期化を行うようにしてもよい。そうすればパフォーマンス問題は回避できるはずだ。
その他のアプローチ
上述の正規表現は主に lookahead をベースに構築されていたが、自分でループを回して処理する場合はどう書けるだろうか?ここでは僕が /(\d)(?=(?:\d{3})+\b)/g を以下のように書き換えてみた:
let digits = number.toFixed(2).toString()
let matcher = /(\d)(?=(?:\d{3})+\b)/g

while (matcher.test(digits)) {
  let first = digits.slice(0, matcher.lastIndex);
  let second = digits.slice(matcher.lastIndex);
  digits = first + "," + second
}
そしてさらに直感的な方法として、ループごとに毎回置換していく方法もある:
let digits = number.toFixed(2).toString()
let matcher = /(\d+)(\d{3})/

while (matcher.test(digits)) {
  digits = digits.replace(matcher, "$1,$2");
}
もう一度結果を見てみよう:
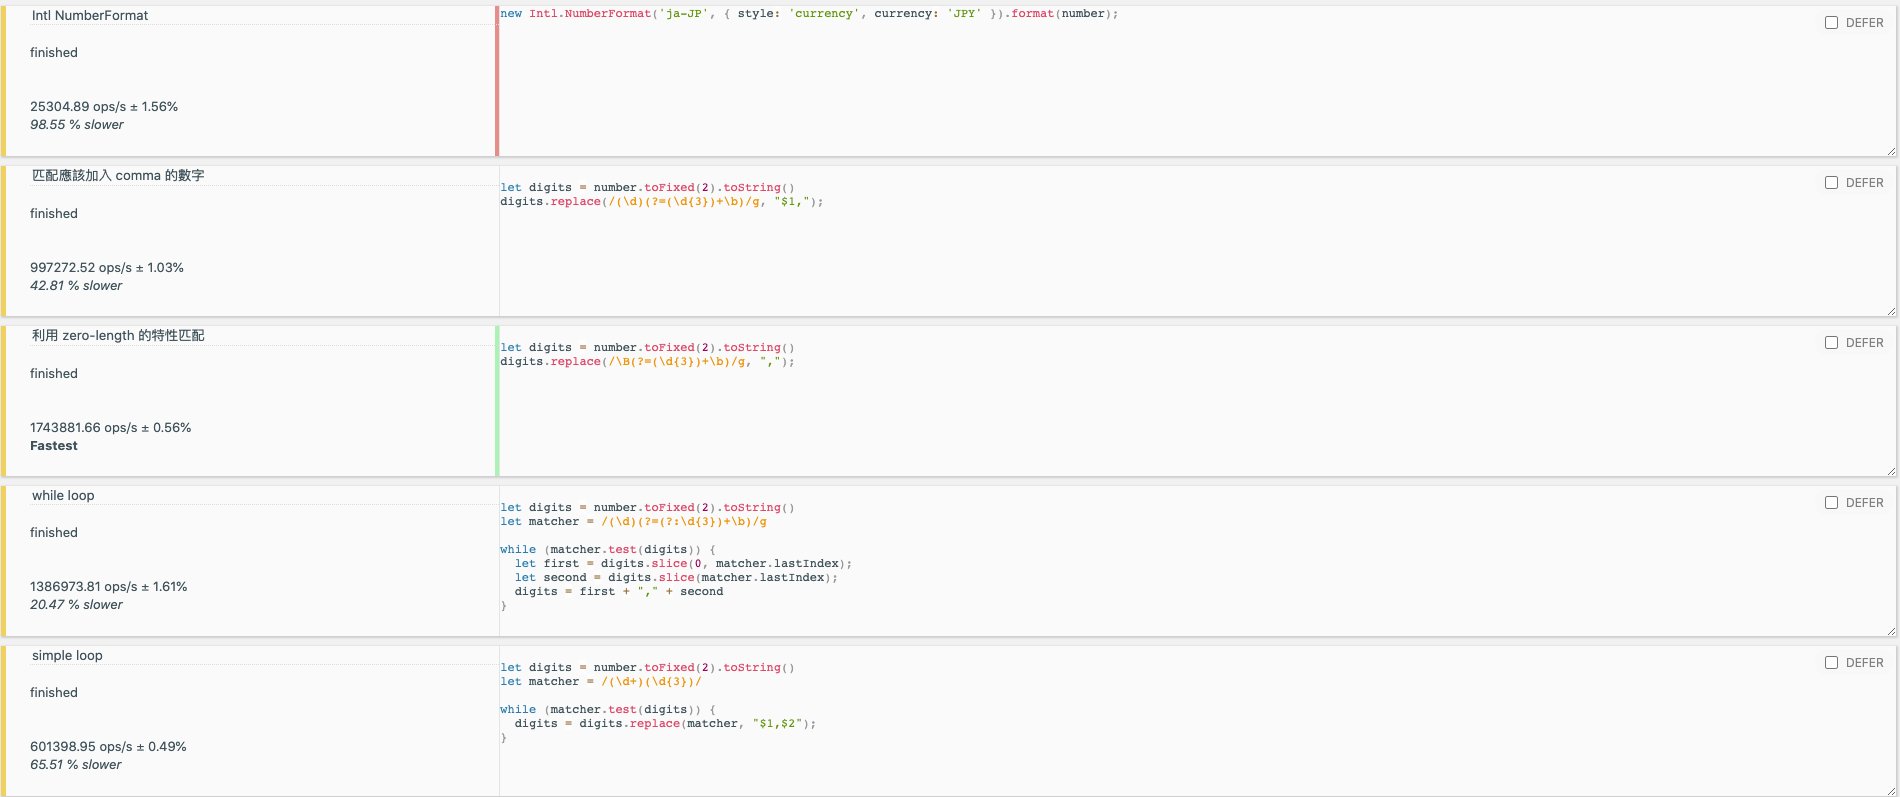
| Name | Ops/s | |
|---|---|---|
Zero-length /\B(?=(\d{3})+\b)/g | 1778943 ops/s fastest | |
| 利用 zero-length 的特性匹配 (without \B) | 1712701 ops/s 3.72% slower | |
| while loop | 1371453 ops/s 22.91% slower | |
| simple loop | 597173.88 ops/s 66.43% slower | |
Intl.NumberFormat | 25304.89 ops/s 98.55% slower |
最も高速なのはやはり zero-length でマッチさせる方法で、その次が while-loop、最も遅いのは依然として Intl.NumberFormat だった。ベンチマーク結果に興味があれば、こちらのリンクから試してみてほしい。
おわりに
正規表現ひとつ取っても語れることは非常に多い。lookahead や word boundary は比較的取り上げられることが少ない概念だが、ここで一度整理してみた。多くの概念は MDN のドキュメントで詳しく説明されているし、Regex101 というサイトを使えば正規表現を可視化でき、横に詳しい解説も表示されてとても便利だ。
とはいえ、正規表現は便利で使い勝手が良いものの、やっぱりパッと見で理解するのは本当に難しいなと僕は思っている。
関連リソース
関連記事
- Three.js で僕の部屋を表現する 僕が React Three Fiber を使って実際の自分の部屋をブラウザ上に再現し、実世界のオブジェクトを目録に見立て、空間の記憶を通してここ数年の生活と仕事について語った話。
- フロントエンドで画像を扱う際に注意すべきこと Jake Archibaldの記事を起点に、現代のレスポンシブ画像の書き方を整理する。なぜwidth/heightを付ける必要があるのか、CSSのaspect-ratioはいつ使うべきか、AVIFとWebPの選び方、そしてpicture/source/srcsetを使ったモバイル向け画像の切り替えについて。
- CSS field-sizing — たった1行のCSSでフォーム要素を自動リサイズする かつてtextareaの自動高さ調整は、JavaScriptでscrollHeightを監視するしかなかった。しかしCSSのfield-sizing: contentなら、わずか1行で代替でき、textarea、input、selectに対応している。本記事では従来のやり方のペインポイントと、field-sizingの使い方をまとめる。
- リンクの下線をもっと見栄え良くする:text-underline-offset デフォルトでは下線と文字が近すぎて、このスタイルを好まないデザイナーもいるし、僕自身もあまり綺麗ではないと感じていた。